robots.txt y bots de IA: qué bloquea cada regla y qué no
El robots.txt es un archivo de texto que se encuentra en la raíz del Sitio Web y que le indica a los bots qué páginas pueden rastrear y cuáles no, y esta semana Google publicó el segundo video de la serie Non-Canonical Cabinet, con Gary Illyes y Cherry Prommawin, dedicado justamente a qué se puede poner dentro de dicho archivo y qué no, con un apartado sobre los bots de inteligencia artificial.
¿Y por qué importa? Porque cuando se habla de bots de IA se suelen mezclar tres cosas que no son lo mismo, que un bot entre al sitio, que use el contenido para entrenar un modelo y que el sitio aparezca citado dentro de una respuesta, y el robots.txt solamente actúa sobre la primera.
¿Qué puede hacer el robots.txt y qué no?
De acuerdo al resumen que hizo Search Engine Roundtable del video, el archivo tiene que seguir el estándar RFC 9309 y Google lo lee línea por línea entendiendo solamente cuatro reglas, user-agent, allow, disallow y sitemap, por lo cual cualquier línea que no entienda la descarta sin avisar y sigue con la siguiente, y Gary da el ejemplo de que si alguien escribe en lenguaje natural algo como no rastrear la página secreta, Google lo ignora y puede terminar rastreando esa página de todas formas.
Lo que dejan claro en el video:
- Los nombres de los bots solo pueden llevar letras y guiones, sin emojis ni caracteres especiales.
- Las rutas con ñ, tildes u otros caracteres que no son del inglés conviene escribirlas con codificación por porcentaje, porque otros rastreadores pueden no interpretarlas.
- El robots.txt no es una medida de seguridad: es un pedido que respetan los bots que se portan bien.
Rastrear no es lo mismo que entrenar
Gary lo dice sin vueltas en el video, el robots.txt es un protocolo de preferencias de acceso en donde un disallow significa no entres a esta habitación y nada más, sin decir nada sobre lo que pasa con lo que el bot ya leyó antes ni sobre si se puede guardar o usar para entrenar un modelo.
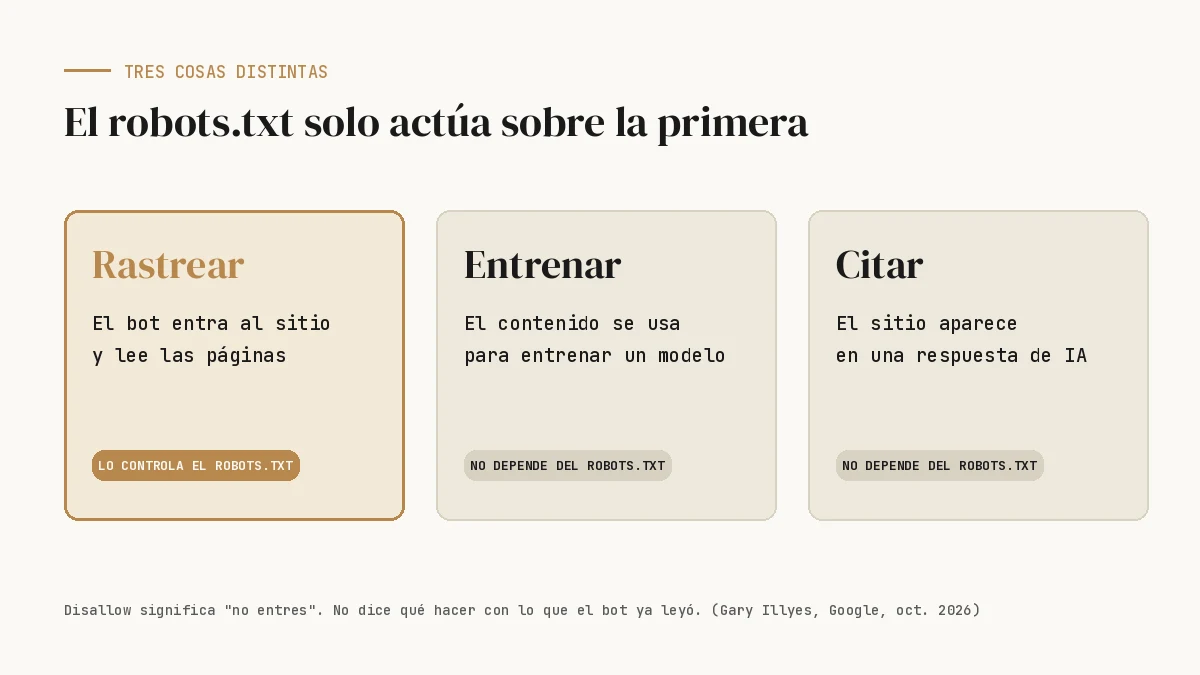
Es por eso que las empresas de IA terminaron separando sus bots, cada uno con un nombre distinto de acuerdo a para qué lo usan, y si se quiere controlar uno en particular hay que nombrarlo dentro del archivo, ya que no existe una regla general que diga no uses mi contenido para la IA.
Los bots que importan hoy
Según la documentación de cada empresa, estos son los nombres y para qué sirve cada uno:
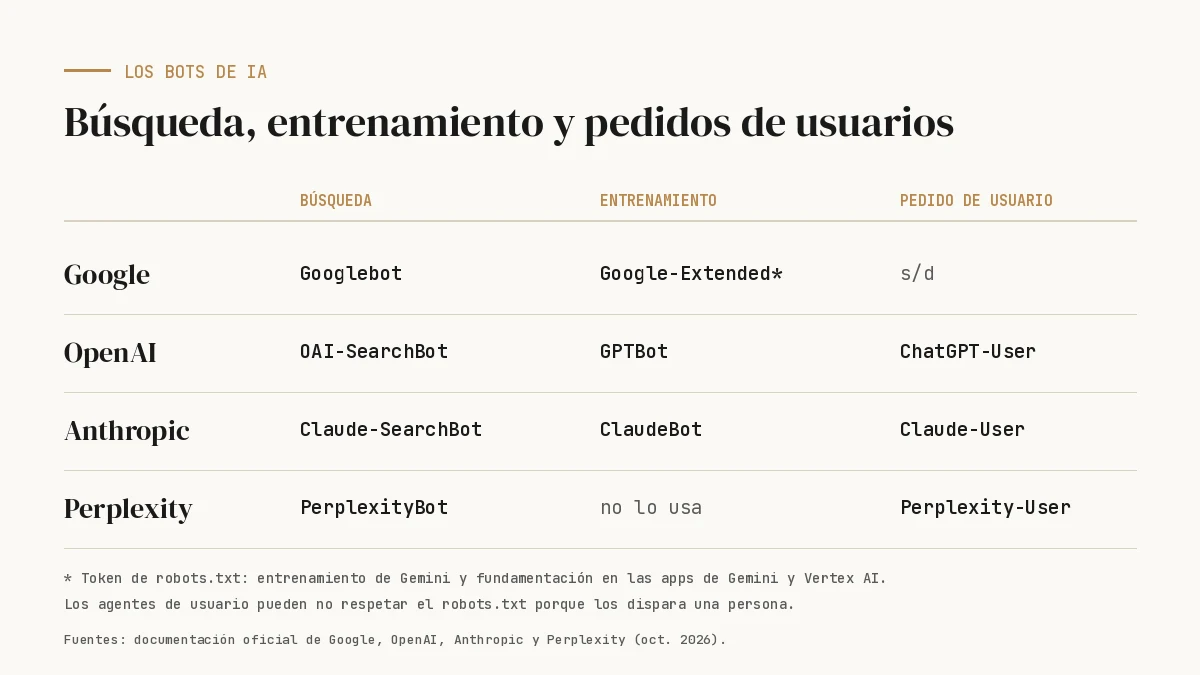
- Google. Googlebot rastrea para la Búsqueda, incluidos AI Overviews y AI Mode. Google-Extended no es un bot sino un token del robots.txt que, según la documentación de rastreadores de Google, controla el entrenamiento de futuros modelos de Gemini y la fundamentación en las apps de Gemini y en Vertex AI. No afecta la inclusión en la Búsqueda ni es señal de ranking.
- OpenAI. Según su página de bots, OAI-SearchBot es el de búsqueda (si se bloquea, el sitio no aparece en las respuestas de búsqueda de ChatGPT), GPTBot es el de entrenamiento y ChatGPT-User entra por pedido de un usuario, por lo que el robots.txt puede no aplicarse. Los cambios tardan unas 24 horas.
- Anthropic. El centro de ayuda de Claude lista ClaudeBot (entrenamiento), Claude-SearchBot (búsqueda) y Claude-User (pedidos de usuarios). Bloquear los dos últimos puede reducir la visibilidad en las búsquedas de Claude. También respeta Crawl-delay.
- Perplexity. Según su documentación, PerplexityBot indexa para mostrar sitios en las respuestas y no se usa para entrenar modelos. Perplexity-User entra por pedido de un usuario y en general ignora el robots.txt.
¿Qué cambió en la documentación de Google?
El mismo día del video Google actualizó la página en donde explica cómo controlar lo que se comparte con la Búsqueda, sumando dos opciones que ya existían pero no figuraban ahí, las metaetiquetas robots, data-nosnippet y X-Robots-Tag por un lado y el control de IA generativa de Search Console por el otro.
Este último es el que importa para esta nota, ya que según la documentación actualizada es la manera de decidir si el sitio aparece en las funciones de IA de la Búsqueda, incluidos AI Overviews y AI Mode, para todo el sitio. Lo cual esto quiere decir que en Google la decisión sobre AI Overviews no pasa por el robots.txt ni por Google-Extended sino por Search Console, y como conté en la nota sobre fuentes preferidas, excluir el sitio de esas funciones también lo deja afuera de la etiqueta de preferida en AI Mode.
Un robots.txt de ejemplo
Este ejemplo deja entrar a los bots de búsqueda de IA y le pide a los de entrenamiento que no rastreen. No es una recomendación para cualquier sitio, es una forma de ver cómo se escribe cada caso.
# Búsqueda con IA: permitidos
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Entrenamiento de modelos: bloqueados
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

# Ojo: también afecta la fundamentación en las apps de Gemini
User-agent: Google-Extended
Disallow: /
Antes de copiarlo:
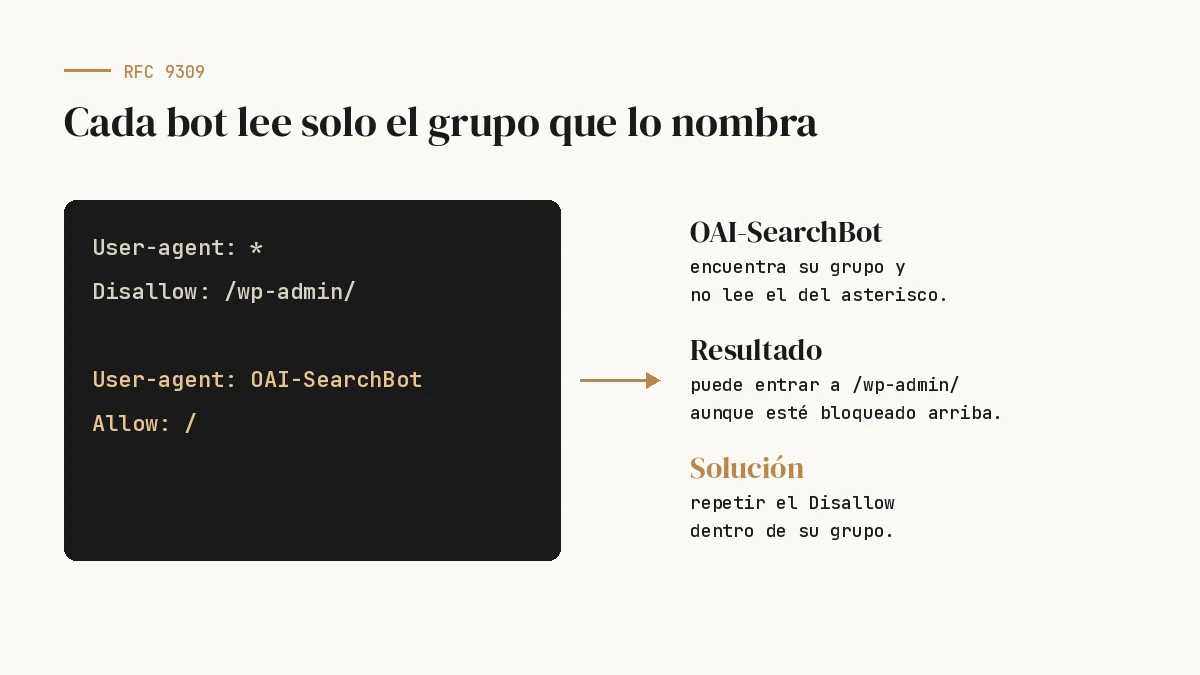
- Cada bot lee solo su grupo. Según el RFC 9309, un bot sigue el grupo que lleva su nombre y solo usa el del asterisco si no hay ninguno. Si en
User-agent: *está bloqueado/wp-admin/y se agrega un grupo para OAI-SearchBot, ese bloqueo hay que repetirlo dentro del grupo nuevo.
¿Cómo decidir qué bloquear?
No se puede definir qué bots bloquear sin antes analizar qué busca el negocio, ya que una cosa es querer estar presente en las respuestas de la IA y otra muy diferente es no querer que el contenido se utilice para entrenar modelos, y cada una se resuelve con bots distintos.
- Para aparecer citado en ChatGPT, Claude o Perplexity: no bloquear OAI-SearchBot, Claude-SearchBot ni PerplexityBot. Según la documentación de cada empresa, bloquearlos saca al sitio de las respuestas.
- Para que el contenido no se use para entrenar: bloquear GPTBot y ClaudeBot. Eso no cambia la visibilidad en la búsqueda de esas herramientas.
- Google-Extended: no toca la Búsqueda, pero sí la fundamentación en las apps de Gemini. Bloquearlo puede significar aparecer menos en las respuestas de Gemini fuera del buscador.
- Antes del robots.txt: revisar el firewall o la CDN, que pueden estar frenando a los bots por IP. Perplexity y Anthropic lo mencionan en su documentación.
- Después del cambio: medir con el reporte AI Performance de Bing y con GA4, con las limitaciones que conté en la nota sobre el tráfico de ChatGPT en GA4.
Es por eso que modificar el robots.txt sin medir antes y después es tomar decisiones a ciegas, y cuando un Sitio Web no aparece en estas herramientas el motivo puede no encontrarse en el archivo sino en la configuración del servidor o de la CDN.