15 RegEx de Search Console para saber si una caída es real
Si en las últimas semanas abriste el rank tracker y viste medio sitio fuera del top 10, la pregunta obvia es si fue el spam update. Puede ser. Pero también puede ser que no haya pasado nada.
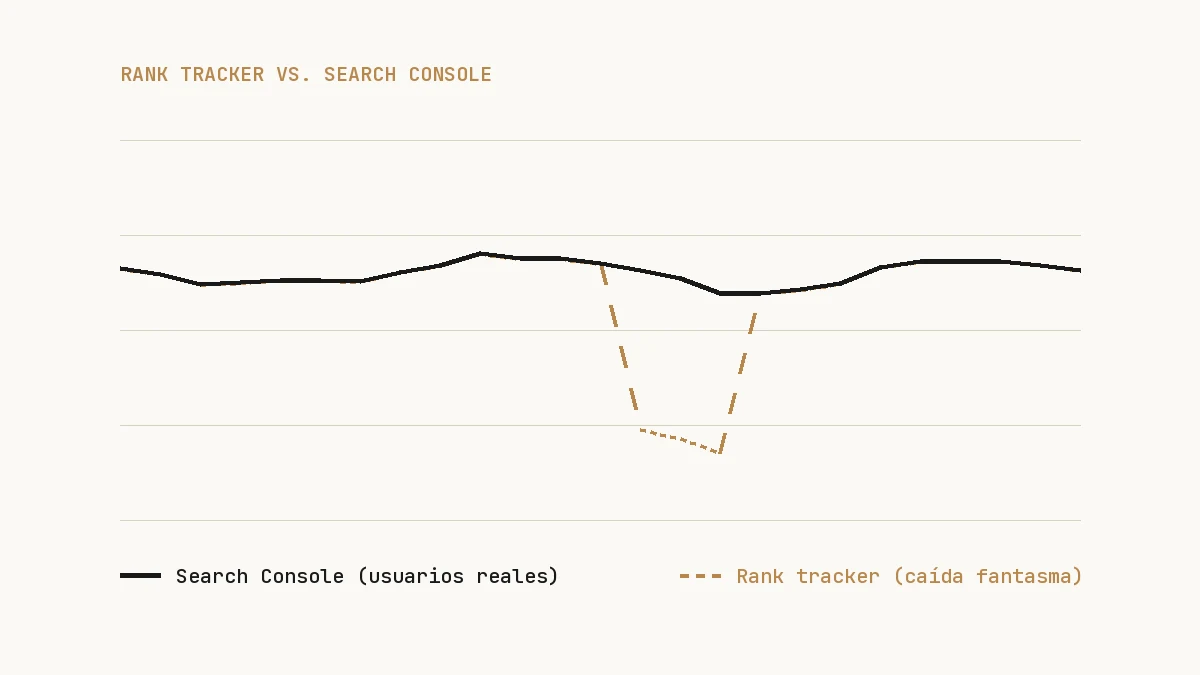
Desde mediados de septiembre muchos rank trackers registran caídas que no siempre son reales. Coincidió con el spam update, que Google desplegó entre el 24 de septiembre y el 8 de octubre, y esa coincidencia es peligrosa, porque invita a reescribir contenido o tocar plantillas por algo que quizás nunca se rompió. Para mí hoy la forma más confiable de confirmar una caída es Search Console bien segmentado, y para eso armé estas 15 RegEx.
Qué está pasando con los trackers
Nozzle, un rank tracker que guarda las SERPs completas de sus clientes, publicó el 10 de octubre un análisis de 27,5 millones de SERPs. Lo que vieron es bastante raro. Desde el 13 de septiembre muchos pedidos a Google empezaron a fallar, y desde el 20 una parte de los que pasaban volvía con una página normal, con el diseño de siempre, pero con otros resultados adentro. Antes eso le pasaba al 0,17% de las SERPs y desde entonces al 8%. Y en esas páginas, un sitio que normalmente está en el top 10 quedaba afuera casi seis de cada diez veces.
Morningscore, que es otro rank tracker, encontró algo parecido por su lado con más de 4 millones de búsquedas: resultados recortados entre el 24 de septiembre y el 2 de octubre, mientras que desde un navegador común se veía todo bien. Google no dijo nada. Que sea una medida contra el scraping lo interpretan estas empresas, no está confirmado, pero el efecto sí se repite, y Search Engine Roundtable juntó avisos de Sistrix, DataForSEO, SE Ranking y Advanced Web Ranking en la misma línea.
Lo que más me preocupa es que no hay ningún error visible. La herramienta guarda la página como si fuera real y el reporte muestra una caída que nunca existió. Yo a eso le digo caída fantasma.
Cómo se carga una RegEx
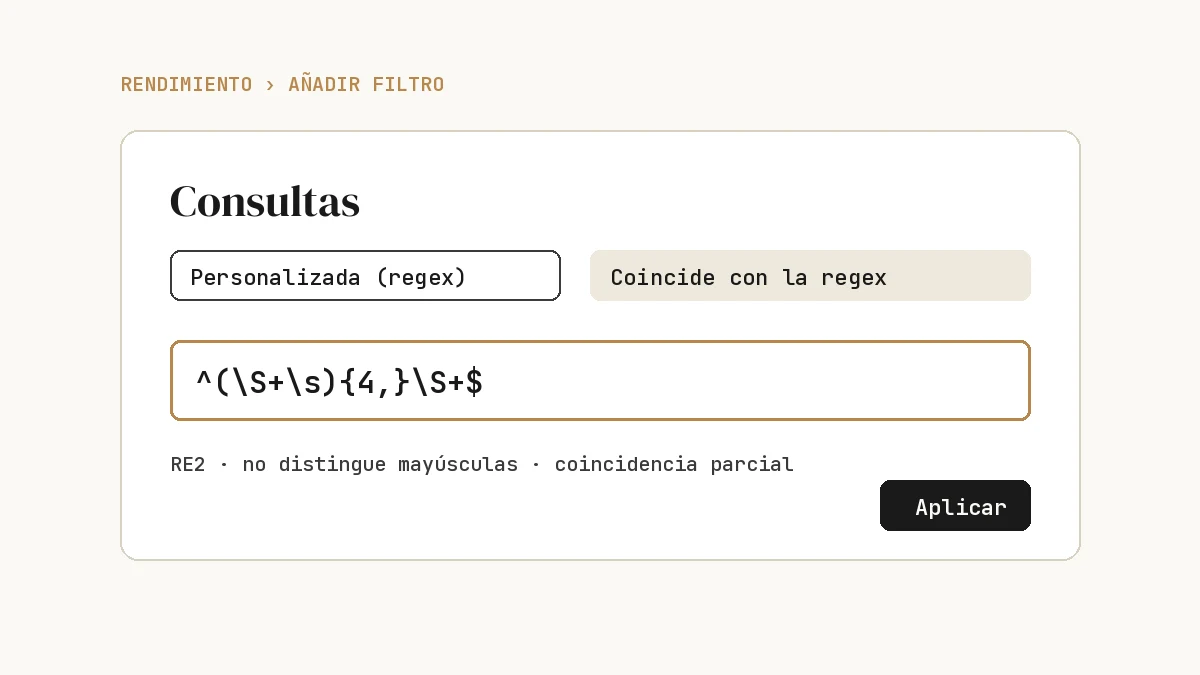
En Rendimiento, + Añadir filtro, después Consultas o Páginas, y ahí Personalizada (regex), con la opción de Coincide o No coincide. Según la ayuda de Search Console se usa sintaxis RE2, no importan las mayúsculas y la coincidencia es parcial, o sea que si no se pone ^ al principio y $ al final, la expresión puede aparecer en cualquier parte de la consulta.
Probé todas con RE2, con casos que tenían que coincidir y otros que no. Donde dice mimarca va tu marca, con las variantes y los errores de tipeo que la gente escribe de verdad.
Las 15 RegEx
1. Las keywords que cayeron en el tracker
Filtro: Consultas, coincide.
^(zapatillas running|zapatillas trail|botines de f[uú]tbol)$Es la primera que correría. Se ponen exactamente las keywords que el tracker marcó como caídas y se mira si en esos días bajaron las impresiones. Si siguen igual, lo más probable es que el problema sea el dato. El f[uú]tbol no es un capricho: Search Console toma “fútbol” y “futbol” como dos consultas distintas.
2. Solo marca
Filtro: Consultas, coincide.
mimarca|mi marca|mimarkaLa marca casi siempre es lo más estable, y según Nozzle fue además lo que menos sufrió los resultados cambiados. Si cae la marca junto con todo lo demás, antes de pensar en SEO miraría si bajó la demanda, por una campaña que se cortó o por temporada. Si la propiedad ya tiene el filtro de consultas de marca de Search Console, mejor todavía.
3. Todo menos la marca
Filtro: Consultas, no coincide.
mimarca|mi marca|mimarkaLa misma expresión, al revés. Acá se ve de verdad si un update te pegó. Marca estable y sin marca en caída justo en una de las olas: ese es el caso en el que sí me sentaría a analizar el update.
4. Long tail
Filtro: Consultas, coincide.
^(\S+\s){4,}\S+$Trae consultas de cinco palabras o más. Nozzle vio más resultados cambiados en frases con menos de 100 búsquedas al mes (9,4% contra 6,1% a 7,1% del resto), aunque aclaro que ellos miden por volumen y esta expresión por palabras, así que es una aproximación. Si el tracker te saca del top 10 un montón de keywords largas y en Search Console están igual, yo desconfiaría del tracker. Un detalle: Search Console omite las consultas anonimizadas, y en long tail son muchas.
5. Genéricas
Filtro: Consultas, coincide.
^\S+(\s\S+)?$Una o dos palabras. Son pocas, pero en muchos sitios concentran buena parte del tráfico sin marca, así que tres posiciones menos en una genérica durante un par de semanas pueden pesar más que cientos de long tail juntas.
6. Búsquedas locales
Filtro: Consultas, coincide.
cerca de (m[ií]|ac[aá]|aqu[ií])|near me|abierto ahoraCon “cerca” sola aparecían cosas como “cerca eléctrica”, por eso quedó así. Nozzle encontró más resultados cambiados en búsquedas “near me”, 11,4% contra 7,8%. Si cae lo local de una sola ciudad, lo primero que revisaría es la ficha de Google Business Profile de esa sucursal, no el sitio.
7. Preguntas
Filtro: Consultas, coincide.
^(qu[eé]|qui[eé]n(es)?|c[oó]mo|cu[aá]ndo|d[oó]nde|por ?qu[eé]|cu[aá]l(es)?|cu[aá]nt[oa]s?)(\s|$)Qué, quién, cómo, cuándo, dónde, por qué, cuál, cuánto, con tilde o sin tilde. Un caso típico en estas consultas es que bajen los clics y las impresiones no. Eso no siempre es posición. A veces hay algo arriba en la página de resultados que ya responde, y antes de reescribir cualquier cosa conviene buscar la consulta y ver qué aparece hoy.
8. Intención de compra
Filtro: Consultas, coincide.
(^|\s)(precios?|barat[oa]s?|ofertas?|descuentos?|compra(r|s)?)(\s|$)|cu[aá]nto (cuesta|sale|vale)Palabras sueltas, si no te trae “precioso”. Si la caída está en esta parte, para mí es prioridad uno, porque es la que vende. Y si se concentra en una categoría, la cruzaría con un filtro de páginas para ver si es una plantilla puntual.
9. Comparativas
Filtro: Consultas, coincide.
(^|\s)(vs\.?|versus|mejores|compar(ativas?|aci[oó]n|ar)|alternativas?)(\s|$)Dejé afuera “mejor” en singular porque traía cosas como “dormir mejor”. En estas búsquedas pelean medios, listados de terceros y foros, y muchas veces una caída acá es competencia de verdad, no un error del tracker.
10. Por tipo de página
Filtro: Páginas, coincide. Una por vez.
/(producto|productos|p)(/|$)
/(categoria|categorias|c)(/|$)
/(blog|guia|guias)(/|$)
Hay que adaptarlas a cada sitio. El (/|$) del final está para las URLs que terminan en /p o /c sin barra, como las de VTEX. Un update casi nunca le pega parejo a todo el sitio. Si se cae /producto/ y el blog no se mueve, el problema está en las fichas.
11. URLs con parámetros
Filtro: Páginas, coincide.
\?La más corta y una de las que más sorpresas da. Si aparecen con impresiones URLs de filtros, de orden o de búsqueda interna que no tendrían que estar indexadas, eso es técnico, y miraría canonicals y robots antes de echarle la culpa a Google.
12. Búsquedas con año
Filtro: Consultas, coincide.
(^|\s)20(2[4-7])(\s|$)“Mejores celulares 2026” y similares. Esta demanda se mueve sola: hacia fin de año la gente empieza a buscar 2027 y lo de 2026 baja, sin que el ranking tenga nada que ver.
13. Navegacionales, con la marca
Filtro: Consultas, coincide.
mimarca.*(login|ingresar|home ?banking|sucursal|horario|tel[eé]fono|contacto)|(login|ingresar|home ?banking|sucursal|horario|tel[eé]fono|contacto).*mimarcaPide la marca adelante o atrás, porque sin ella se colaban cosas como “horarios de trenes”. Son clientes que ya existen buscando el login o una sucursal. Si eso cae, rara vez es SEO. Primero preguntaría si cambió la URL de acceso o si el sitio estuvo caído.
14. Opiniones y reclamos, con la marca
Filtro: Consultas, coincide.
mimarca.*(opini[oó]n|rese[ñn]a|reclamo|queja|estafa|es confiable|es seguro)|(opini[oó]n|rese[ñn]a|reclamo|queja|estafa|es confiable|es seguro).*mimarcaSi estas suben la misma semana en que baja el resto de la marca, el tema probablemente sea reputación. Y esa charla es con atención al cliente, no con el equipo de desarrollo.
15. Paginación
Filtro: Páginas, coincide.
/page/\d+|[?&](page|paged|pagina)=\d+Saqué ?p= a propósito, porque en WordPress es el ID de una nota. Cuando caen solo las páginas 2 en adelante, típico después de cambiar una plantilla, suele ser algo técnico: links de paginación o canonicals.
Cómo combinarlas
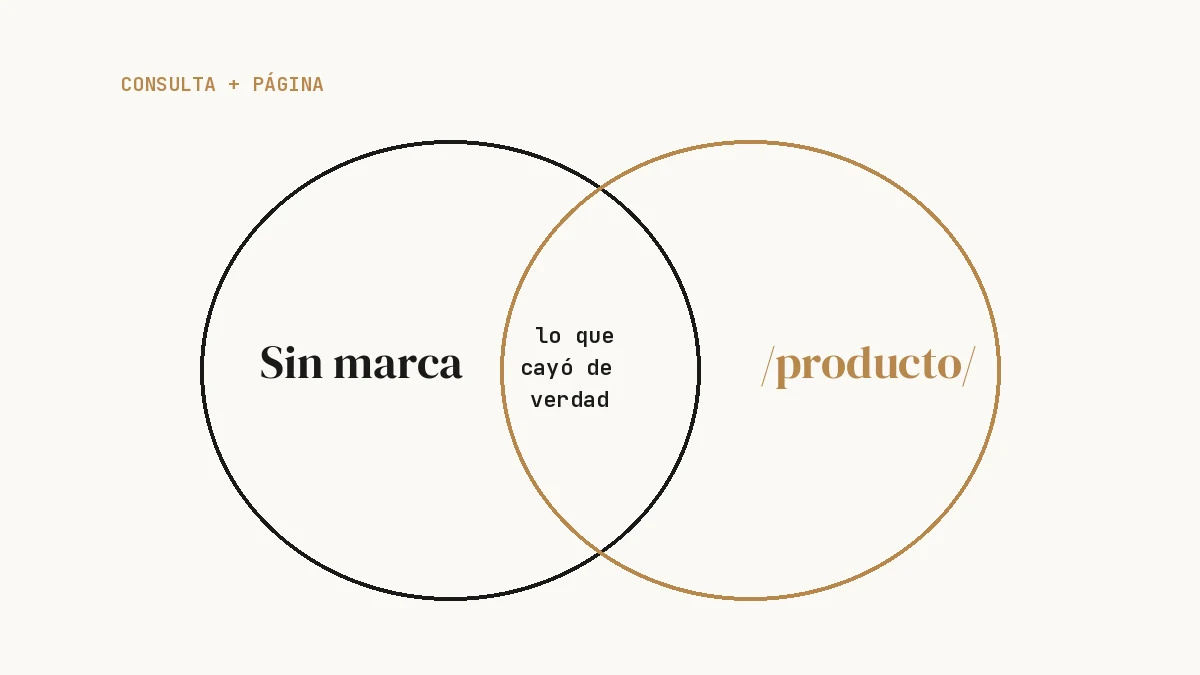
Lo mejor viene cuando se cruzan. Search Console deja filtrar consulta y página al mismo tiempo, entonces se puede poner “todo menos la marca” en Consultas y la de productos en Páginas, y ver solo el tráfico sin marca de las fichas. Long tail con blog, compra con categorías. Así se pasa de “cayó el sitio” a “cayó esto, en estas páginas”, que es una conversación muy distinta con un cliente.
Cuando subí estas RegEx a LinkedIn, Nicolás Billia agregó algo que suscribo: comparar la posición de la URL para cada consulta y no el promedio de la consulta sola. Contó un caso de vuelos en el que la consulta daba posición 6 porque unas 20 URLs de rutas sumaban impresiones bien abajo, cuando la URL que trabajaban estaba en la 2. Se ve filtrando la consulta exacta y abriendo la pestaña Páginas. En sitios grandes lo haría directo con la API de Search Console, que agrupa consulta y página juntas y acepta las mismas RegEx, o con la exportación a BigQuery.
Cómo leer lo que sale
Yo compararía por semana, que es lo que recomienda Google para no mezclar un lunes con un sábado, y además contra el mismo período del año anterior, porque si no la estacionalidad te engaña. Si las dos comparaciones dicen lo mismo, la caída es real.
Otra cosa que se olvida: los trackers suelen medir una ubicación y un dispositivo, y Search Console por defecto mezcla todo. Antes de comparar hay que filtrar el mismo país, el mismo dispositivo y el tipo de búsqueda Web. Y no hay que esperar que los totales cierren al filtrar por consulta, porque hay truncamiento de datos y consultas anonimizadas.
Mi regla para estas semanas es simple. Ninguna decisión por una caída de un día en una herramienta de terceros. Según Nozzle casi ocho de cada diez de estas SERPs se normalizan en tres días, y Morningscore vio algo parecido. Si la caída se sostiene, Search Console la confirma y encima coincide con una ola del update, ahí sí la miraría como conté en la nota sobre el spam update de septiembre de 2026.
En América Latina
Nozzle publicó los datos por país y la región quedó arriba de Estados Unidos, que dio 8,5%: Colombia 11,5%, Perú 10,3%, México 9,9%, Brasil y Chile 9,6%, Argentina 9,2%. España, 3,4%. Yo los tomaría como orientación nada más, porque las muestras son chicas. En Argentina miraron unas 34.000 SERPs y en Estados Unidos más de 10 millones.
En finanzas y banca, siempre con datos de Estados Unidos, el promedio fue 9,3% y el peor día llegó a 34,3%. Y ahí es donde más cuidado tendría, porque en un banco cualquier cambio de contenido pasa por legales y compliance, y mover algo por un dato falso sale caro.